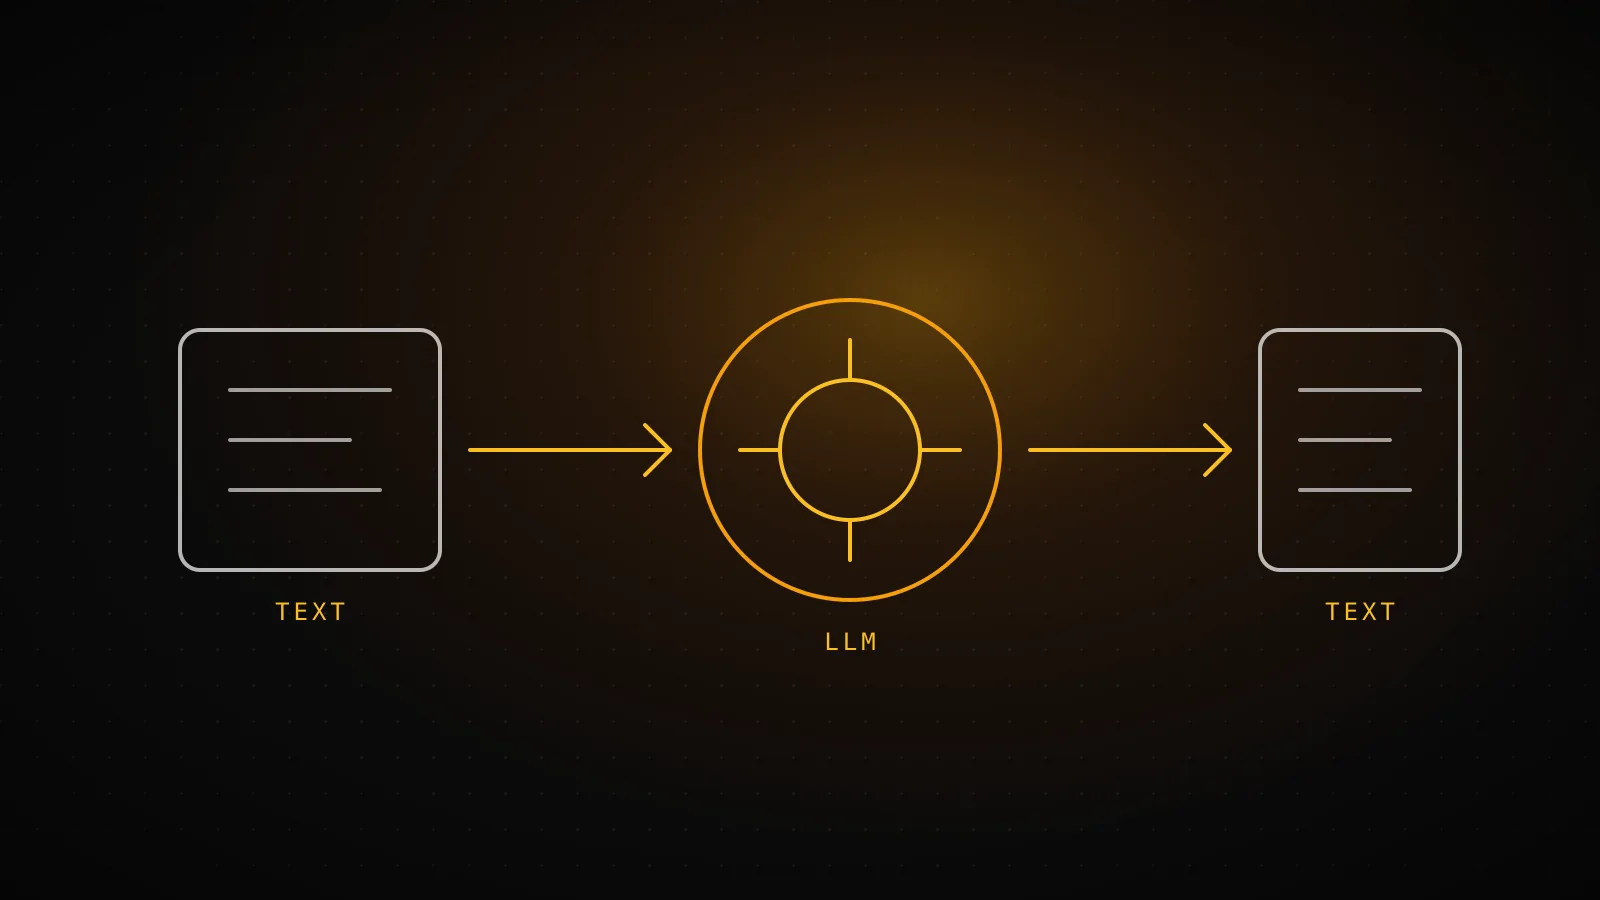
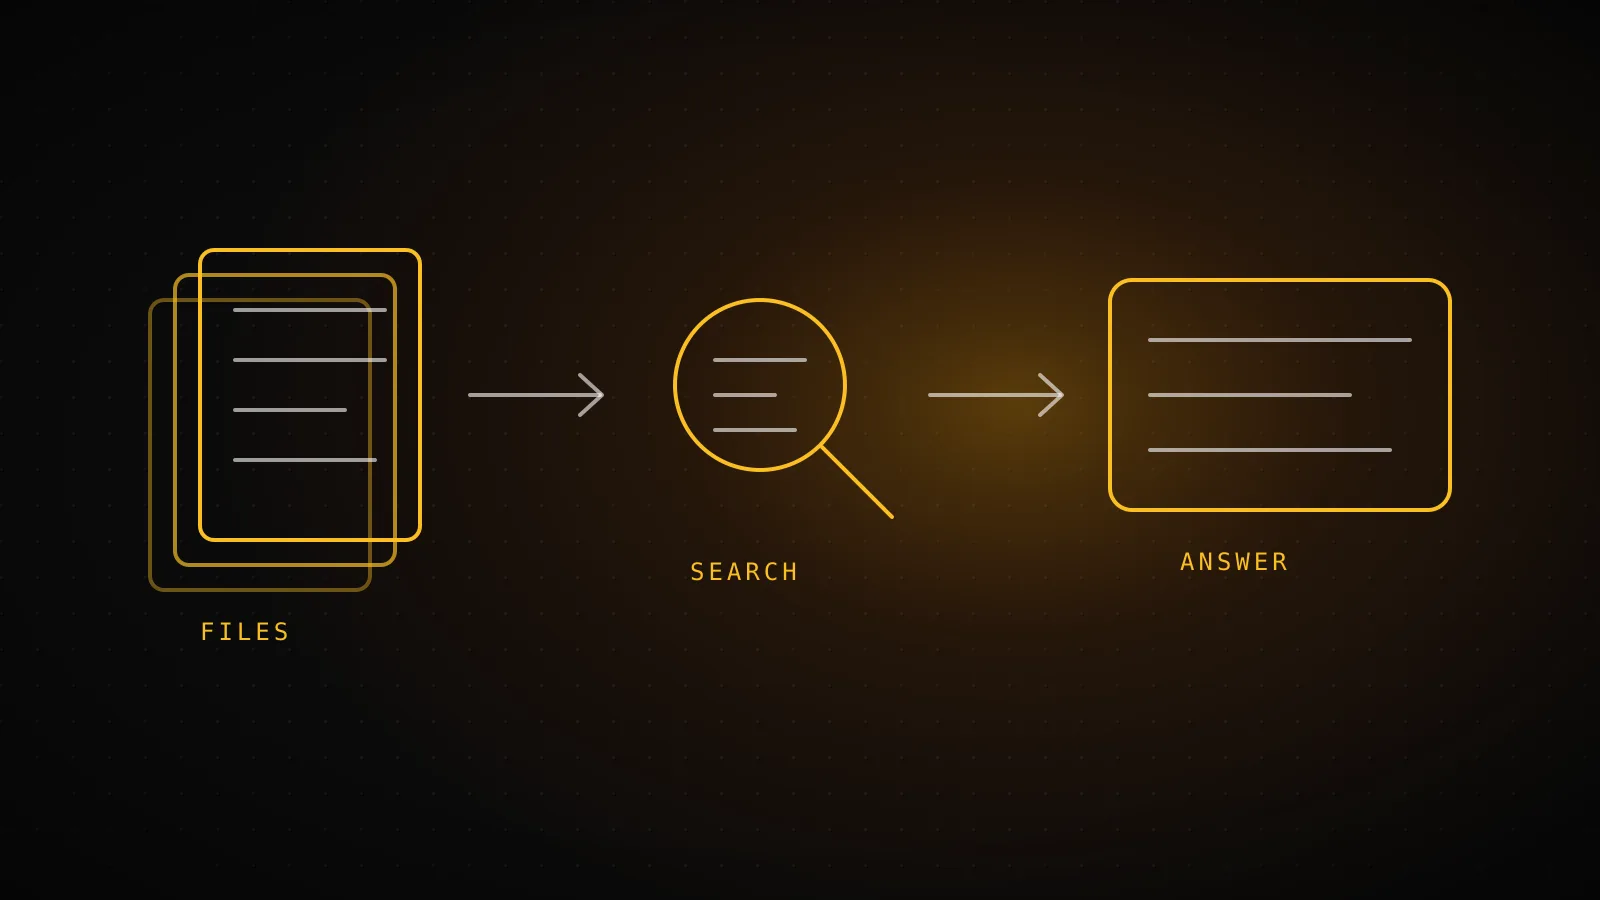
RAG הוא שיטה שבה מערכת בינה מלאכותית מחפשת קודם במסמכים שלכם, ורק אחר כך עונה. היא מוצאת את הקטעים שקשורים לשאלה, מצרפת אותם לשאלה, ומודל שפה מנסח תשובה על סמך מה שנמצא. כך אפשר לשאול "מה היה סכום ההפקדות לקרן הפנסיה של הלקוח הזה" ולקבל תשובה מהקובץ שלו, עם הפניה לקובץ.
בקצרה: RAG הוא חיפוש בתוספת ניסוח. הוא טוב רק כמו המסמכים שהוא מחפש בהם: קבצים חסרים, בלי שם או ישנים נותנים תשובה חלקית שנשמעת שלמה. לכן הצעד הראשון הוא איסוף מסודר של המסמכים, לא בחירת כלי.
מה זה RAG, שלב אחרי שלב
השם נשמע מורכב, אבל הפעולה פשוטה. ארבעה שלבים:
- חיתוך. המסמכים נחתכים לקטעים קצרים, בדרך כלל פסקה או עמוד.
- אינדוקס. כל קטע הופך לרצף מספרים שמייצג את המשמעות שלו, ונשמר במאגר שאפשר לחפש בו לפי דמיון במשמעות ולא רק לפי מילה זהה.
- שליפה. כשמישהו שואל שאלה, המערכת מוצאת כמה קטעים קרובים אליה במשמעות.
- ניסוח. הקטעים והשאלה נשלחים יחד למודל שפה, והוא כותב תשובה שמבוססת עליהם.
ההבדל מחיפוש רגיל במחשב: חיפוש רגיל מחזיר רשימת קבצים. RAG מחזיר משפט, ולכן קל לשכוח שמאחוריו יש חיפוש שיכול לפספס.
דוגמה: שאלה על 60 תיקי לקוחות
נניח משרד עם 60 לקוחות, 8 מסמכים לכל לקוח, בממוצע 3 עמודים למסמך. החשבון:
| שלב | מספר |
|---|---|
| קבצים | 60 × 8 = 480 |
| עמודים | 480 × 3 = 1,440 |
| קטעים באינדקס, קטע לעמוד | 1,440 |
| קטעים שנשלחים למודל בכל שאלה, חמישה | 5 |
המודל לא קורא את 1,440 העמודים בכל שאלה. הוא רואה חמישה קטעים. אם התשובה נמצאת בקטע השישי, הוא לא יודע שהיא קיימת.
עכשיו הבעיה המשרדית. השאלה: "אצל אילו לקוחות סכום ההפקדות לפנסיה גבוה מהשנה שעברה?". נניח ש-12 מתוך 60 לקוחות עדיין לא העלו את אישור הפנסיה. המערכת תענה על 48 לקוחות, בנוסח מלא ובטוח, ולא תגיד שחמישית מהמשרד לא נבדקה. הכלי לא רואה מה חסר, כי אי אפשר לחפש בקובץ שלא הגיע.
זו הנקודה שרוב ההסברים על RAG מדלגים עליה: חיפוש מכסה את מה שנמצא במאגר, ולא את מה שהיה צריך להיות בו.
מה צריך כדי שזה יעבוד
שלושה תנאים, לפי סדר החשיבות:
- המסמכים הגיעו. כל מה שחסר בתיק הוא חור בתשובה. לפני שמחברים כלי, צריך לדעת מי העלה מה ומי עדיין לא.
- כל קובץ מסומן. אם הקובץ נקרא `scan_0042.pdf`, גם אדם וגם מערכת לא יודעים אם זה תלוש, אישור או הסכם. שם ברור ושיוך ללקוח מאפשרים גם לסנן לפני החיפוש ("רק אישורי פנסיה של הלקוח הזה") וזה מקטין טעויות יותר מכל שדרוג של מודל.
- הקבצים קריאים. סריקה עקומה או תמונה מטושטשת הופכות לטקסט שגוי, והחיפוש עובד על הטקסט השגוי.
כמה זה עולה ואיפה הנתונים
אפשר להתחיל בכלים מוכנים שמאפשרים להעלות קבצים ולשאול עליהם, בלי לבנות כלום. מה שבדקנו בדפי הספקים עצמם, נכון לאוקטובר 2026:
| כלי | מחיר | מה אומר הספק על הנתונים |
|---|---|---|
| Claude, חבילת Team עם Projects | 25 דולר למושב בחודש בחיוב חודשי, 20 דולר בחיוב שנתי | לפי עמוד הפרטיות של הספק, קלט ופלט של מוצרים מסחריים לא משמשים לאימון כברירת מחדל. איפה הנתונים נשמרים: לא בדקנו |
| Microsoft 365 Copilot Business, תוספת | 25.20 דולר למשתמש בחודש בחיוב חודשי. בחיוב שנתי 18 דולר, מחיר מבצע לשנה ראשונה עד סוף 2026 ללקוחות Microsoft 365 קיימים | מיקום נתונים בישראל קיים בתוכנית Multi-Geo, אבל לפי תיעוד Microsoft היא מיועדת ללקוחות ארגוניים ומנויים לעסקים קטנים אינם זכאים לה |
| Supabase עם pgvector, בנייה עצמית | מ-25 דולר בחודש לתוכנית Pro | התוסף pgvector מאפשר לשמור וקטורים בתוך Postgres. אזורי אחסון: לא אימתנו בדף המחירים |
שלושה דברים לקחת מהטבלה. הראשון: ברמת מחיר של עשרות דולרים בחודש, העלות איננה המכשול. השני: מיקום הנתונים הוא התשובה שהכי קשה להשיג מהספק, ומשרד קטן לא תמיד יקבל אותה. השלישי: מי שבונה לבד על מסד נתונים לוקח על עצמו גם את האבטחה והתחזוקה. המחירים משתנים, ולכן ביום ההחלטה קוראים שוב את דף המחירים ואת תנאי הספק, לפני שמעלים תיק לקוח.
איפה RAG טועה
- שליפה שגויה. השאלה "הכנסות 2024" עלולה להחזיר קטע על 2023, כי המשמעות קרובה. המודל יענה על הקטע שקיבל.
- מסמך כפול או ישן. אם בתיק יש שתי גרסאות של אותו אישור, המערכת לא יודעת איזו מחייבת.
- שאלה על הכול. "כמה לקוחות חייבים לנו מסמך" אינה שאלה על קטעים אלא על ספירה. RAG לא סופר, וצריך לשאול את הלוח, לא את הצ'אט.
- פרטיות. תיק לקוח מכיל מידע רגיש. הקבצים יוצאים מהמשרד אל שרתים של הספק, ולכן מה שנאמר בשלוש השאלות על הנתונים הוא תנאי להעלאה ולא הערת שוליים.
RAG, חיפוש רגיל וסוכן: מה ההבדל
| חיפוש רגיל | RAG | סוכן | |
|---|---|---|---|
| מה מחזיר | רשימת קבצים | משפט עם הפניה לקובץ | פעולה שבוצעה |
| מתאים ל | "איפה הקובץ של הלקוח" | "מה כתוב בו על X" | "שלח תזכורת וסמן בלוח" |
| הסיכון | כמעט אין | תשובה שגויה בביטחון | פעולה שגויה בעולם |
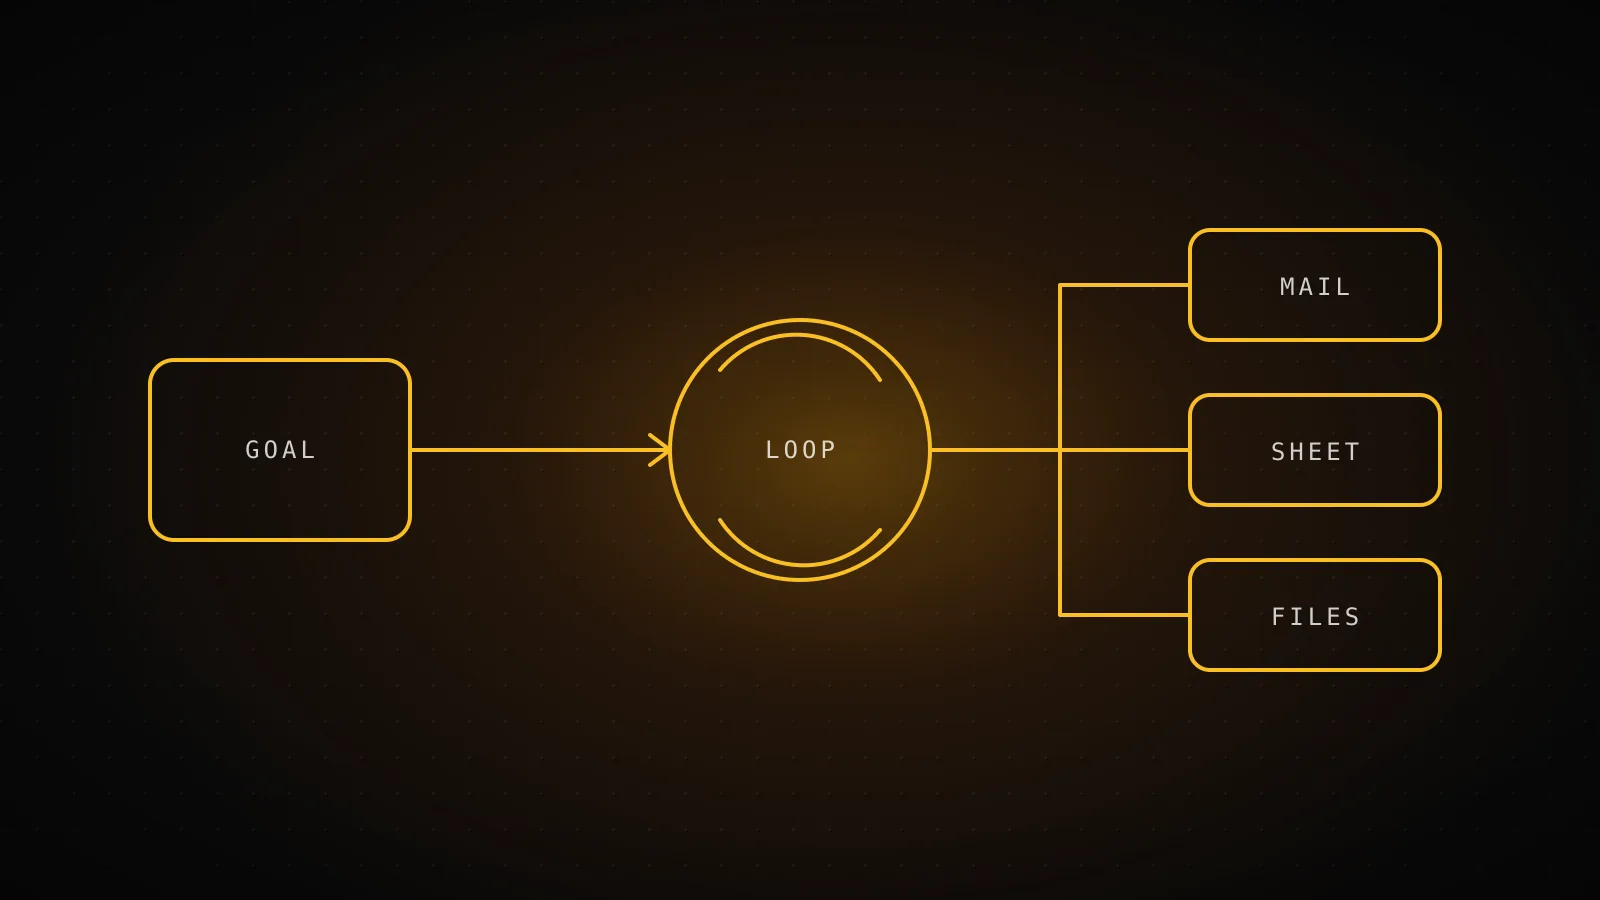
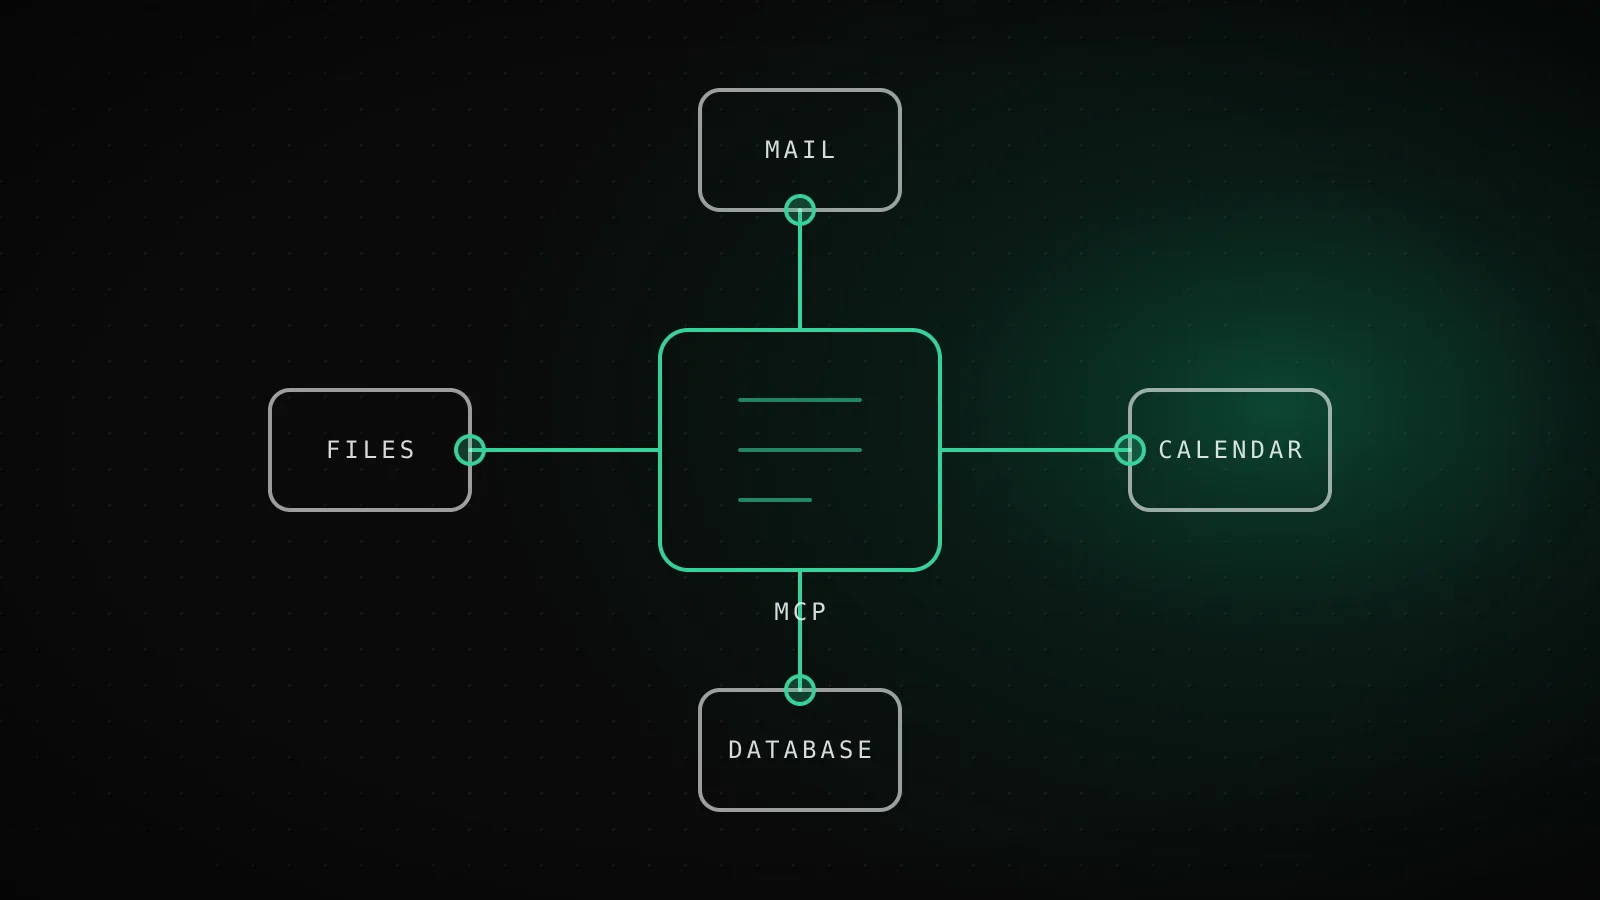
על סוכנים יש מדריך נפרד, וחיבור כלים למערכות המשרד מוסבר במדריך על MCP.
למה הצעד הראשון הוא איסוף מסמכים
כל השלבים למעלה מתחילים מאותו מקום: מסמכים שהגיעו, מסומנים לפי לקוח וסוג, ועם ידיעה ברורה מה עדיין חסר. את זה ה-RAG לא עושה, וגם לא צריך לעשות.
בפועל, אצל רוב המשרדים הקבצים מגיעים במייל, בוואטסאפ ובצילומי מסך, ומישהו מסדר אותם ידנית. זה השלב הראשון שכדאי לאוטמט, והוא אוטומציה רגילה, בלי בינה מלאכותית. Paperbot עושה בדיוק את זה: כל לקוח מקבל קישור אישי, מעלה לתוך משבצות עם שם (למשל "אישור פנסיה"), והלוח מראה מה הגיע ומה חסר, עם תזכורות בימי עבודה. התוצאה היא תיקים מסודרים, ורשימה ברורה של מי עדיין לא שלח. Paperbot לא קורא את הקבצים ולא עונה על שאלות עליהם. זה עבודה של כלי אחר, שעדיף שיתחבר אחרי שהתיקים מלאים.
מתי לא צריך RAG
- כשיש פחות מכמה עשרות מסמכים. חיפוש רגיל בתיקייה מסודרת מהיר ואמין יותר.
- כשהשאלה היא ספירה או סטטוס ("מי לא שלח"). לשם נועד לוח.
- כשהתשובה יוצאת ללקוח בלי שאדם קרא אותה.
- כשאין תשובה כתובה מהספק על נתונים של לקוחות.
שאלות נפוצות
מה זה RAG בקצרה?
RAG הוא קיצור של Retrieval-Augmented Generation. קודם המערכת מחפשת במסמכים שלכם את הקטעים שקשורים לשאלה, ואחר כך מודל שפה מנסח תשובה לפיהם. התשובה נשענת על החומר שלכם ולא על מה שהמודל זוכר.
מה ההבדל בין RAG לבין צ'אט בינה מלאכותית רגיל?
צ'אט רגיל עונה ממה שלמד באימון. מערכת RAG מקבלת יחד עם השאלה קטעים מהמסמכים שלכם, ולכן יכולה לענות על לקוחות ותיקים שהמודל מעולם לא ראה, ולהראות מאיזה קובץ בא כל משפט.
האם RAG מבטל טעויות של הבינה המלאכותית?
לא. הוא מקטין אותן. אם החיפוש מצא קטע לא נכון, או שהמסמך חסר או ישן, המודל ינסח תשובה בביטחון על בסיס חומר שגוי. לכן מספר או תאריך שיוצאים ממנו נבדקים מול המקור.
האם RAG בטוח למסמכים של לקוחות?
תלוי בספק. לפני שמעלים תיקי לקוחות בודקים לאן הקבצים נשלחים, כמה זמן הם נשמרים והאם משתמשים בהם לאימון. בלי תשובה כתובה לשלוש השאלות, מעלים רק חומר שאינו רגיש.
מה צריך כדי להתחיל עם RAG במשרד?
קבצים שנאספו במקום אחד, עם שם ברור לכל מסמך ולכל לקוח, ורשימה של מה שעדיין חסר. הכלי עצמו הוא החלק הקל. הסדר בקבצים הוא החלק שקובע אם התשובות שימושיות.